一次请求, 放进 30 张图
在 Yovid 生成器里,Seedance 2.5 每次最多读取 30 张参考图和 10 段参考视频。下面字节跳动的演示用了 8 张:一只纸片小狗的角色设定图、一只真的拉布拉多、一间卧室、一个宠物喂食器、一个玩具箱和一幅儿童画,全都出现在同一个 25 秒的场景里。
 Seedance 2.5
交给模型的是一份演员表,而不是一张首帧。上传人物、产品、服装或地点的照片,在提示词里标注它们,Yovid 会在 Seedance 2.5、Wan 3.0、MiniMax H3 等模型上围绕它们编排一个新场景。
参考图是要让模型认出来的东西,而不是视频必须从它开始的那一帧。Yovid 把每个文件交给模型,作为身份、服装、产品细节、场景或风格的来源,模型再按你写的运镜和动作构建一个新镜头。一个角色就是这样撑起一整个系列的,白桌上拍的一件产品也能这样出现在街景里。
在 Yovid 生成器里,Seedance 2.5 每次最多读取 30 张参考图和 10 段参考视频。下面字节跳动的演示用了 8 张:一只纸片小狗的角色设定图、一只真的拉布拉多、一间卧室、一个宠物喂食器、一个玩具箱和一幅儿童画,全都出现在同一个 25 秒的场景里。
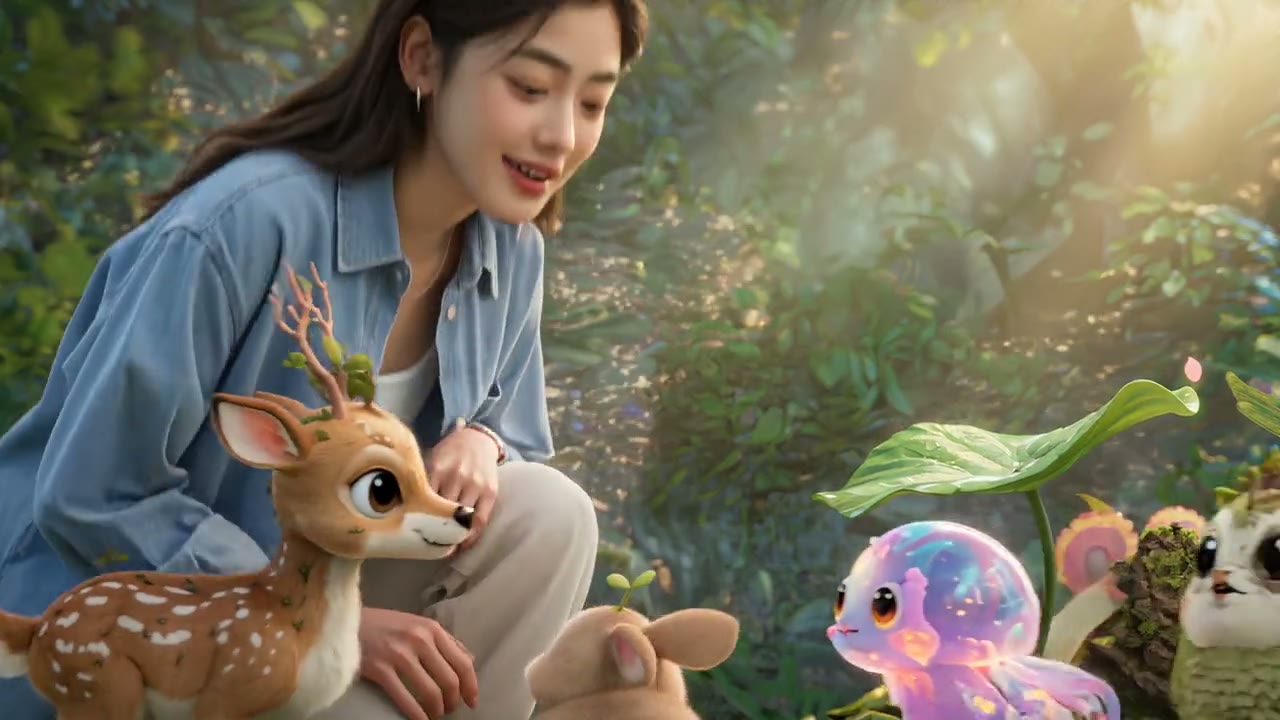
Seedance 2.5Wan 3.0 最多接收 10 张图片和 5 段视频。在阿里巴巴的示例里,一张人像定下女主角,一张图定下莲花秘境,另外七张设定图各画着一只 2D 和 3D 的生物;九张图的内容都出现在同一个 30 秒镜头里。
 Wan 3.0
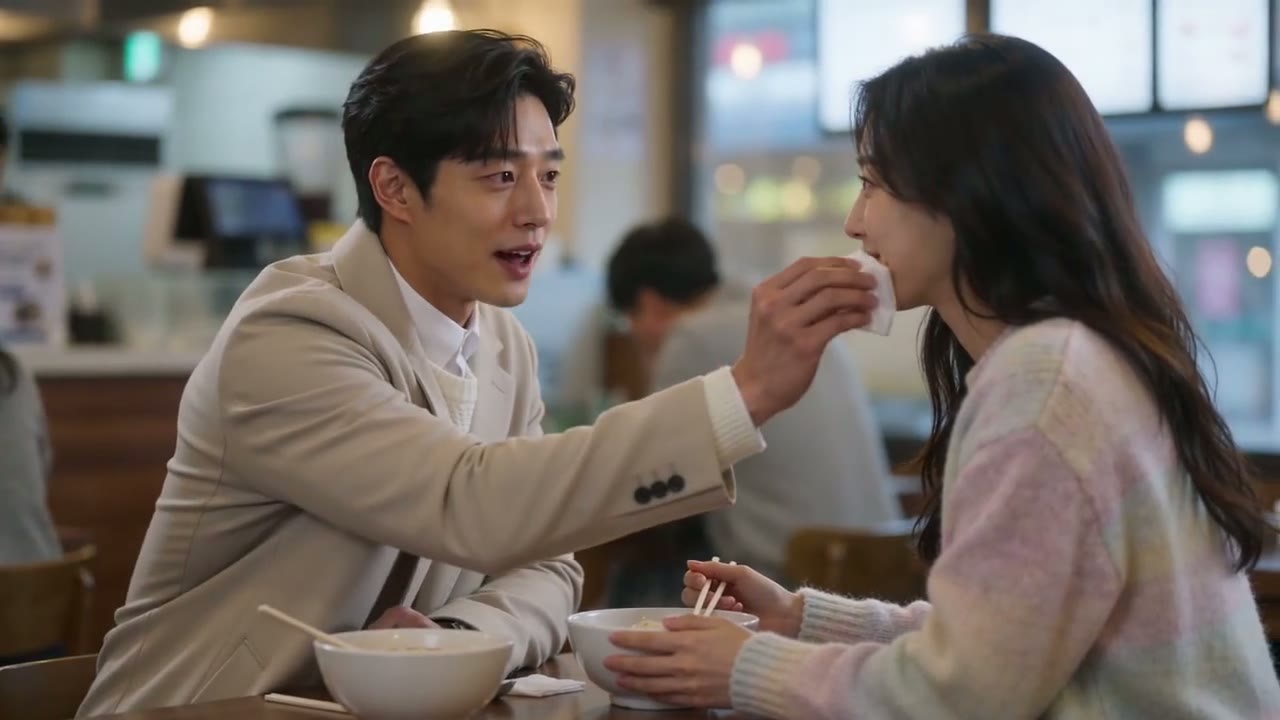
两张脸来自人像照,吸面条的动作来自一段短视频。Seedance 2.0 系列每次最多接收 9 张图片和 3 段 2 到 15 秒的视频;把每个文件标成 @Image 或 @Video,模型就知道它是做什么用的。
 Seedance 2.0
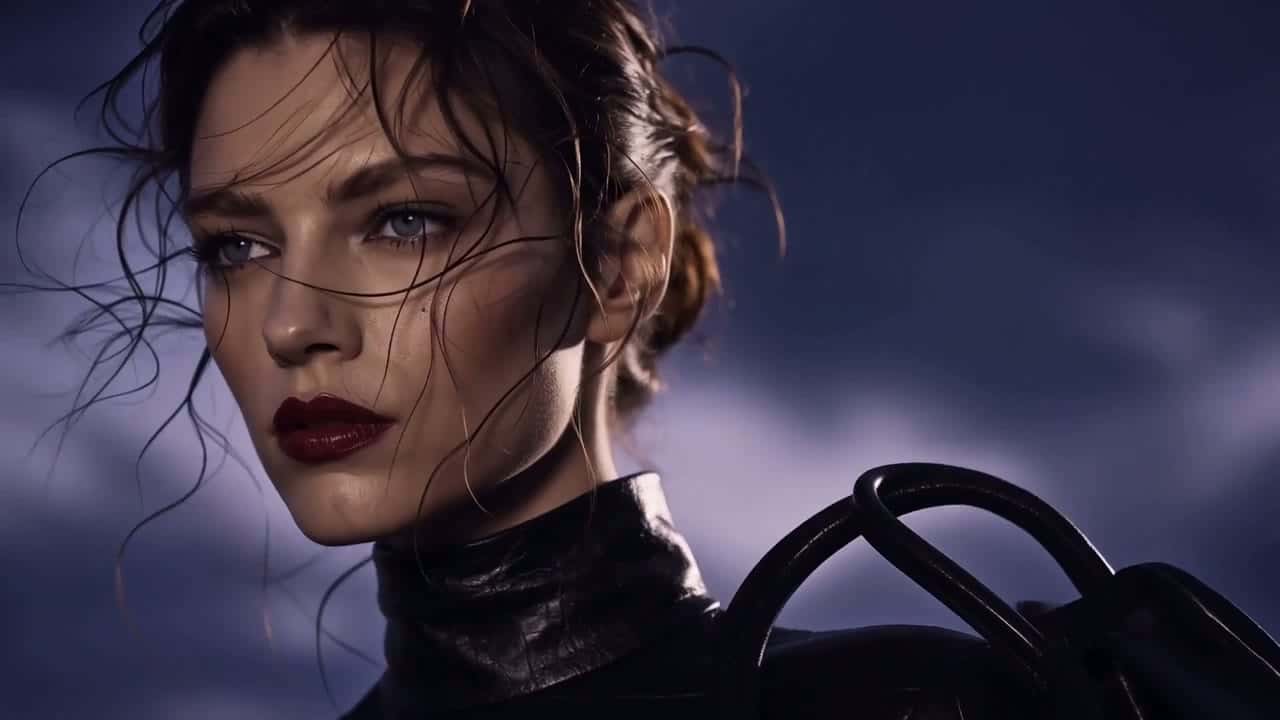
一张情绪板、一张角色设定图、一只从三个角度拍的手袋,再加上结尾 logo:靠这四张参考图,MiniMax H3 剪出一支 15 秒的 2K 广告,手袋和片尾画面始终和原样一致。
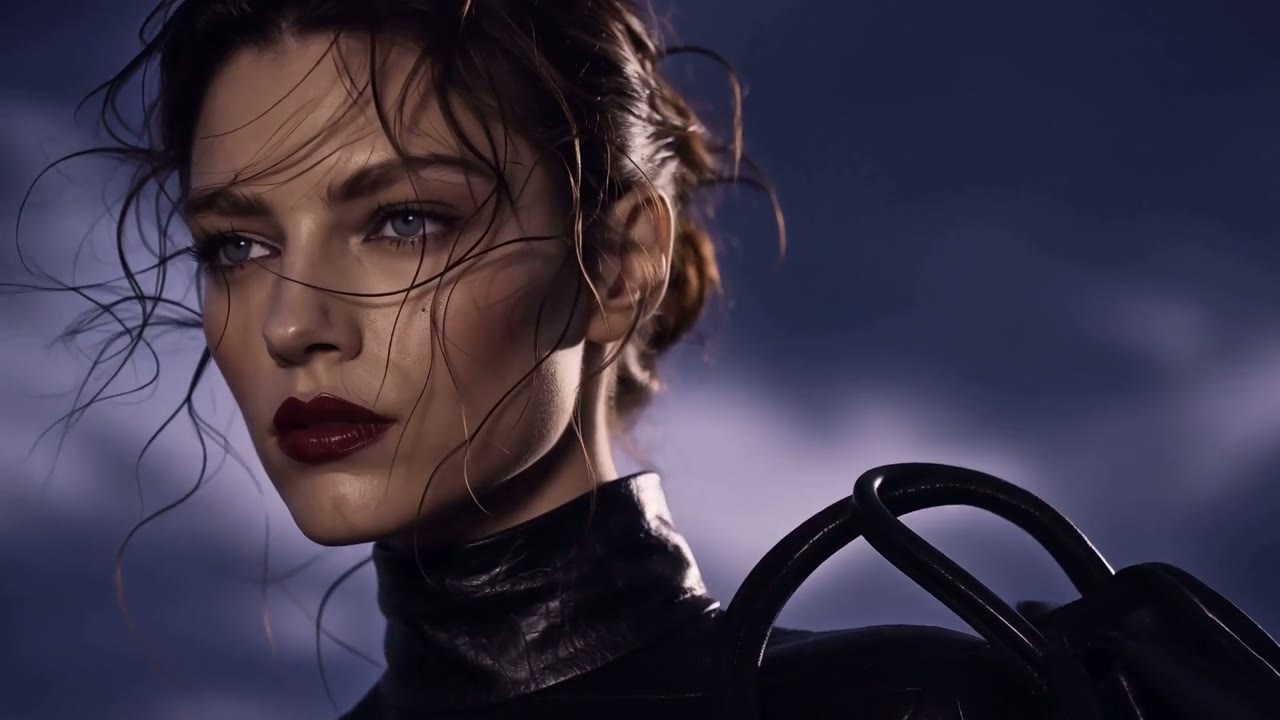
 MiniMax H3
在这次 Yovid 生成里,三张关于一位披萨师傅和他小店的照片,让他在街上的夜景、烤炉前和柜台交接这几个画面里都认得出来。沿用同一组参考图和同样的写法,就能围绕他做一个系列。
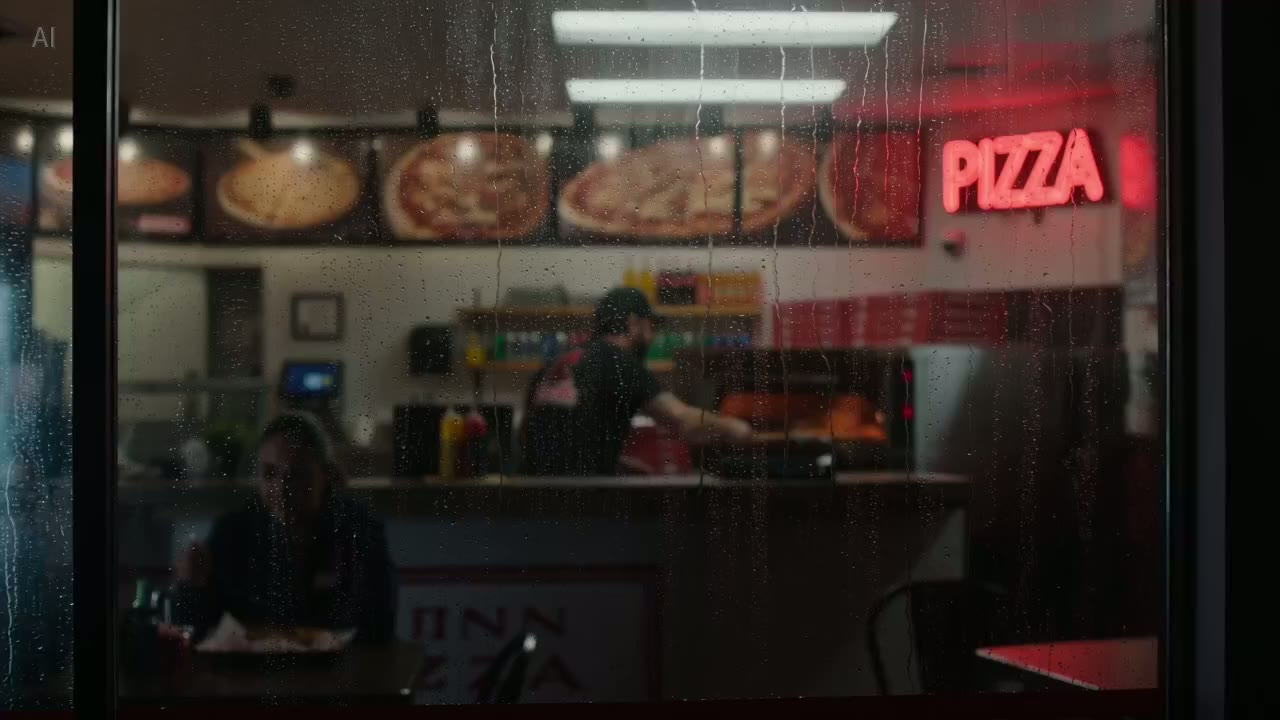 Seedance 2.0
Seedance 2.5 能放的参考素材最多,Wan 3.0 用最多 10 张图生成 30 秒镜头,MiniMax H3 输出 2K,Seedance 2.0 Mini 可以用免费积分先把整个流程跑一遍。
上限和费率直接取自生成器自己的设置,模型一变,这张表也会跟着变。
| 模型 | 参考图 | 参考视频 | 参考视频时长 | 输出时长 | 最高分辨率 | 免费积分可用 | 每秒积分 |
|---|---|---|---|---|---|---|---|
 Seedance 2.5 | 30 | 10 | 2–30 秒 | 4–30 秒 | 1080p | 不支持 | 6.1(720p) |
| Seedance 2.0 | 9 | 3 | 2–15 秒 | 4–15 秒 | 4K | 不支持 | 4(720p) |
| Seedance 2.0 Fast | 9 | 3 | 2–15 秒 | 4–15 秒 | 1080p | 不支持 | 3.75(720p) |
| Seedance 2.0 Mini | 9 | 3 | 2–15 秒 | 4–15 秒 | 720p | 支持 | 2.5(720p) |
| Wan 3.0 | 10 | 5 | 1–15 秒 | 2–30 秒 | 1080p | 不支持 | 2.4(720p) |
 MiniMax H3 | 9 | 3 | 2–15 秒 | 5–15 秒 | 2K | 不支持 | 4.55(2K) |
 Kling 4.0 | 10 | 5 | 3–30 秒 | 3–30 秒 | 1080p | 不支持 | 3(720p) |
| Kling O3 | 不支持 | 1 | 3–10 秒 | 4–10 秒 | 1080p | 不支持 | 不支持 |
每秒积分是带参考图生成时的标准价,未计套餐折扣。Seedance 系列、Kling 4.0 和 Wan 3.0 上,图片不额外计费;MiniMax H3 从第 6 张图起每张约加 1.4 积分。参考视频会改变计费方式:Seedance 按参考视频秒数加输出秒数,用更便宜的参考视频费率计费;Kling 4.0 按输出秒数,再加参考视频和输出两者中较长的秒数,同样用更便宜的参考视频费率;Wan 3.0 和 MiniMax H3 两部分都按正常费率计费;Kling O3 只按输出计费。Wan 3.0 的参考视频和输出共用 30 秒的总时长。免费积分最高 720p。
使用场景
复用同一组参考图,让同一个主持人、吉祥物或角色贯穿每一集、每支广告和每条短片。
把产品图放进厨房、山路或城市街道,形状、颜色和 logo 都保持原样。
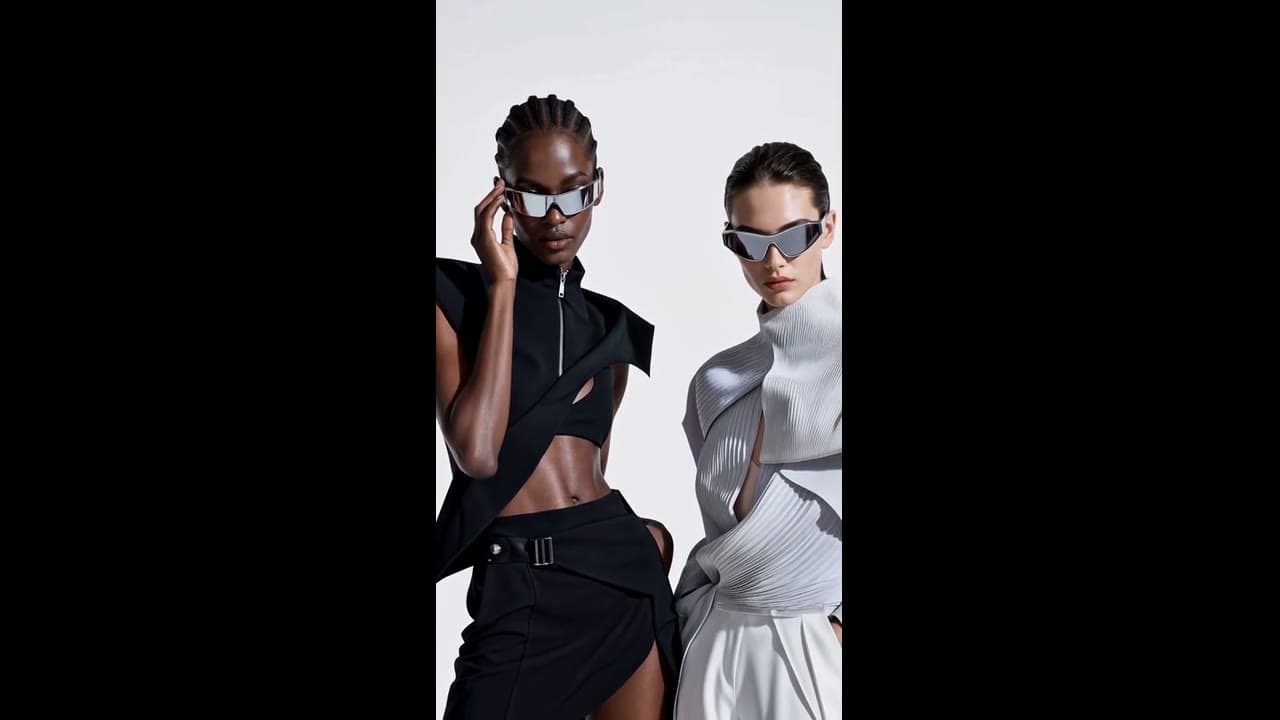
把分开拍的模特、服装和配饰照片,组合成一支有造型的时尚短片。
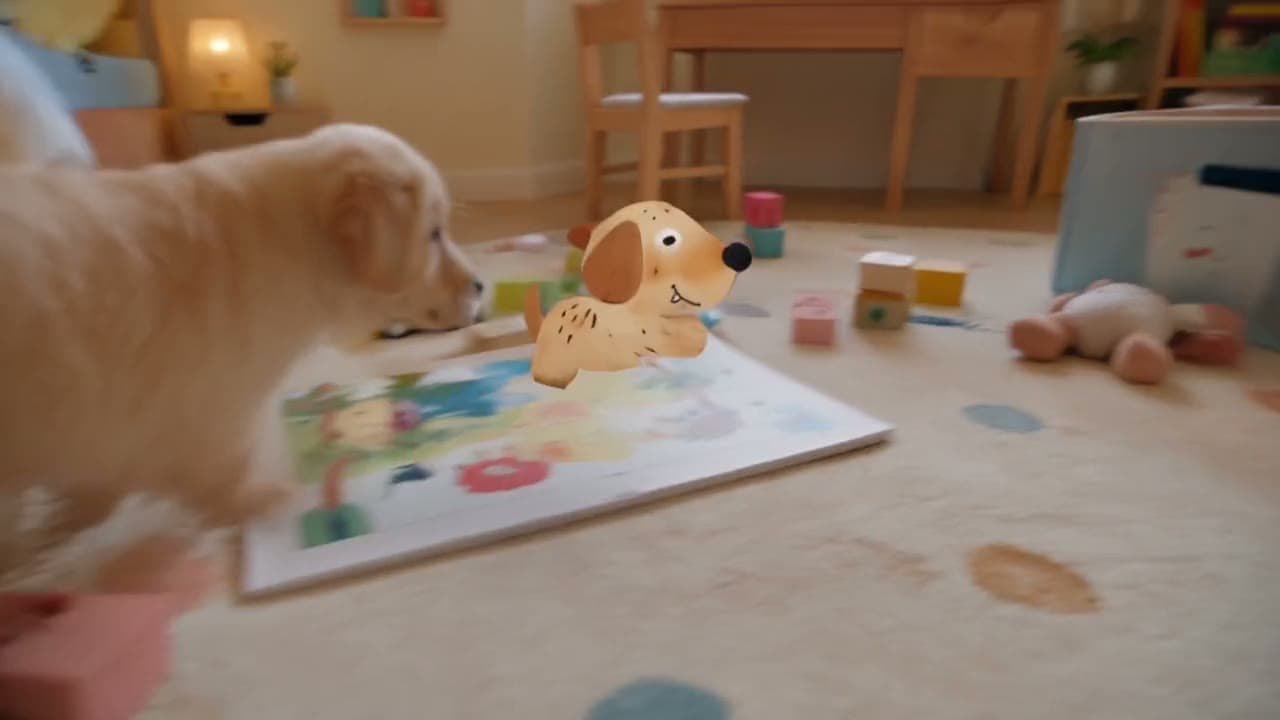
角色设定图和手绘稿变成会表演的角色,每个镜头都保持原有设计。
第 1 步
每个人物一张图,服装或产品一张,地点或风格一张。背景干净、主体看得清,帮助最大。
第 2 步
放入三张或更多图片,它们就会作为参考图使用。在提示词里输入 @,上传的文件会列成 @Image 1、@Image 2 等;给每个文件写明用途。
第 3 步
写下一个还不存在的场景里的动作、运镜和光线,选好时长,确认积分后点击生成。
“@Image 1 的脸,@Image 2 的夹克”,远比五张照片不加说明管用。在提示词里写明每个文件的作用。
正面、侧面和背面,哪怕拼在一张设定图里,也能让人物或吉祥物在镜头绕着走时依然认得出。
不必再用文字描述脸或服装。和图片对不上的文字,会把结果从图片那边拉偏。
每条提示词里的图片、标注和措辞都保持一模一样,只改变动作和运镜。
干净的背景,加上“标签和瓶盖严格保持 @Image 3 里的样子”这样的指令,能护住最关键的卖点细节。
模型服务商可能拒绝名人、真人面孔或受保护的角色。生成失败不扣积分。
相关工具
参考图只是几种输入方式之一。按手头的素材挑合适的那种,账号和积分都是同一套。